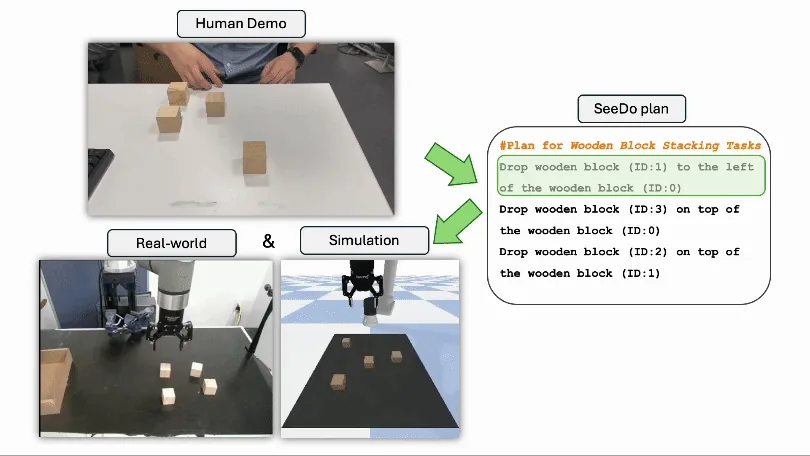
VLM See, Robot Do: Human Demo Video to Robot Action Plan via Vision Language Model Beichen Wang*, Juexiao Zhang*, Shuwen Dong, Irving Fang, Chen Feng Reasoning arXiv ·Code ·Project IROS 2025